基于指标的评估
提示
Feature availability 功能可用性
基于指标的评估可用于:
- n8n Cloud: Pro、Enterprise
- Self-hosted: Enterprise
Registered Community 和 Starter 计划用户也可以将其用于单个工作流。
什么是基于指标的评估?
一旦您的工作流程准备好部署,您通常希望在比构建它时更多的示例上对其进行测试。
例如,当生产执行开始遇到边缘情况时,您希望将它们添加到测试数据集中,以确保它们得到覆盖。
对于从生产数据构建的大型数据集,仅凭观察结果很难了解性能。相反,您必须测量性能。基于指标的评估可以为每次测试运行分配一个或多个分数,您可以将其与之前的运行进行比较。单个分数汇总起来以测量整个数据集的性能。
此功能允许您运行计算指标的评估,跟踪这些指标在运行之间的变化,并深入了解这些变化的原因。
指标可以是确定性函数(例如两个字符串之间的距离),或者您可以使用 AI 来计算它们。指标通常涉及检查输出与参考输出(也称为基准真值)的距离。为此,数据集必须包含该参考输出。但是,某些评估不需要此参考输出(例如,检查文本的情感或毒性)。
工作原理
提示
Credentials for Google Sheets Google 表格的凭据
评估使用数据表或 Google Sheets 来存储测试数据集。要使用 Google 表格作为数据集源,请配置 Google 表格凭据。
- 设置轻评估
- 将指标添加到工作流程中
- 运行评估并查看结果
1.设置灯光评估
按照设置说明 创建数据集并将其连接到您的工作流程,将输出写回数据集。
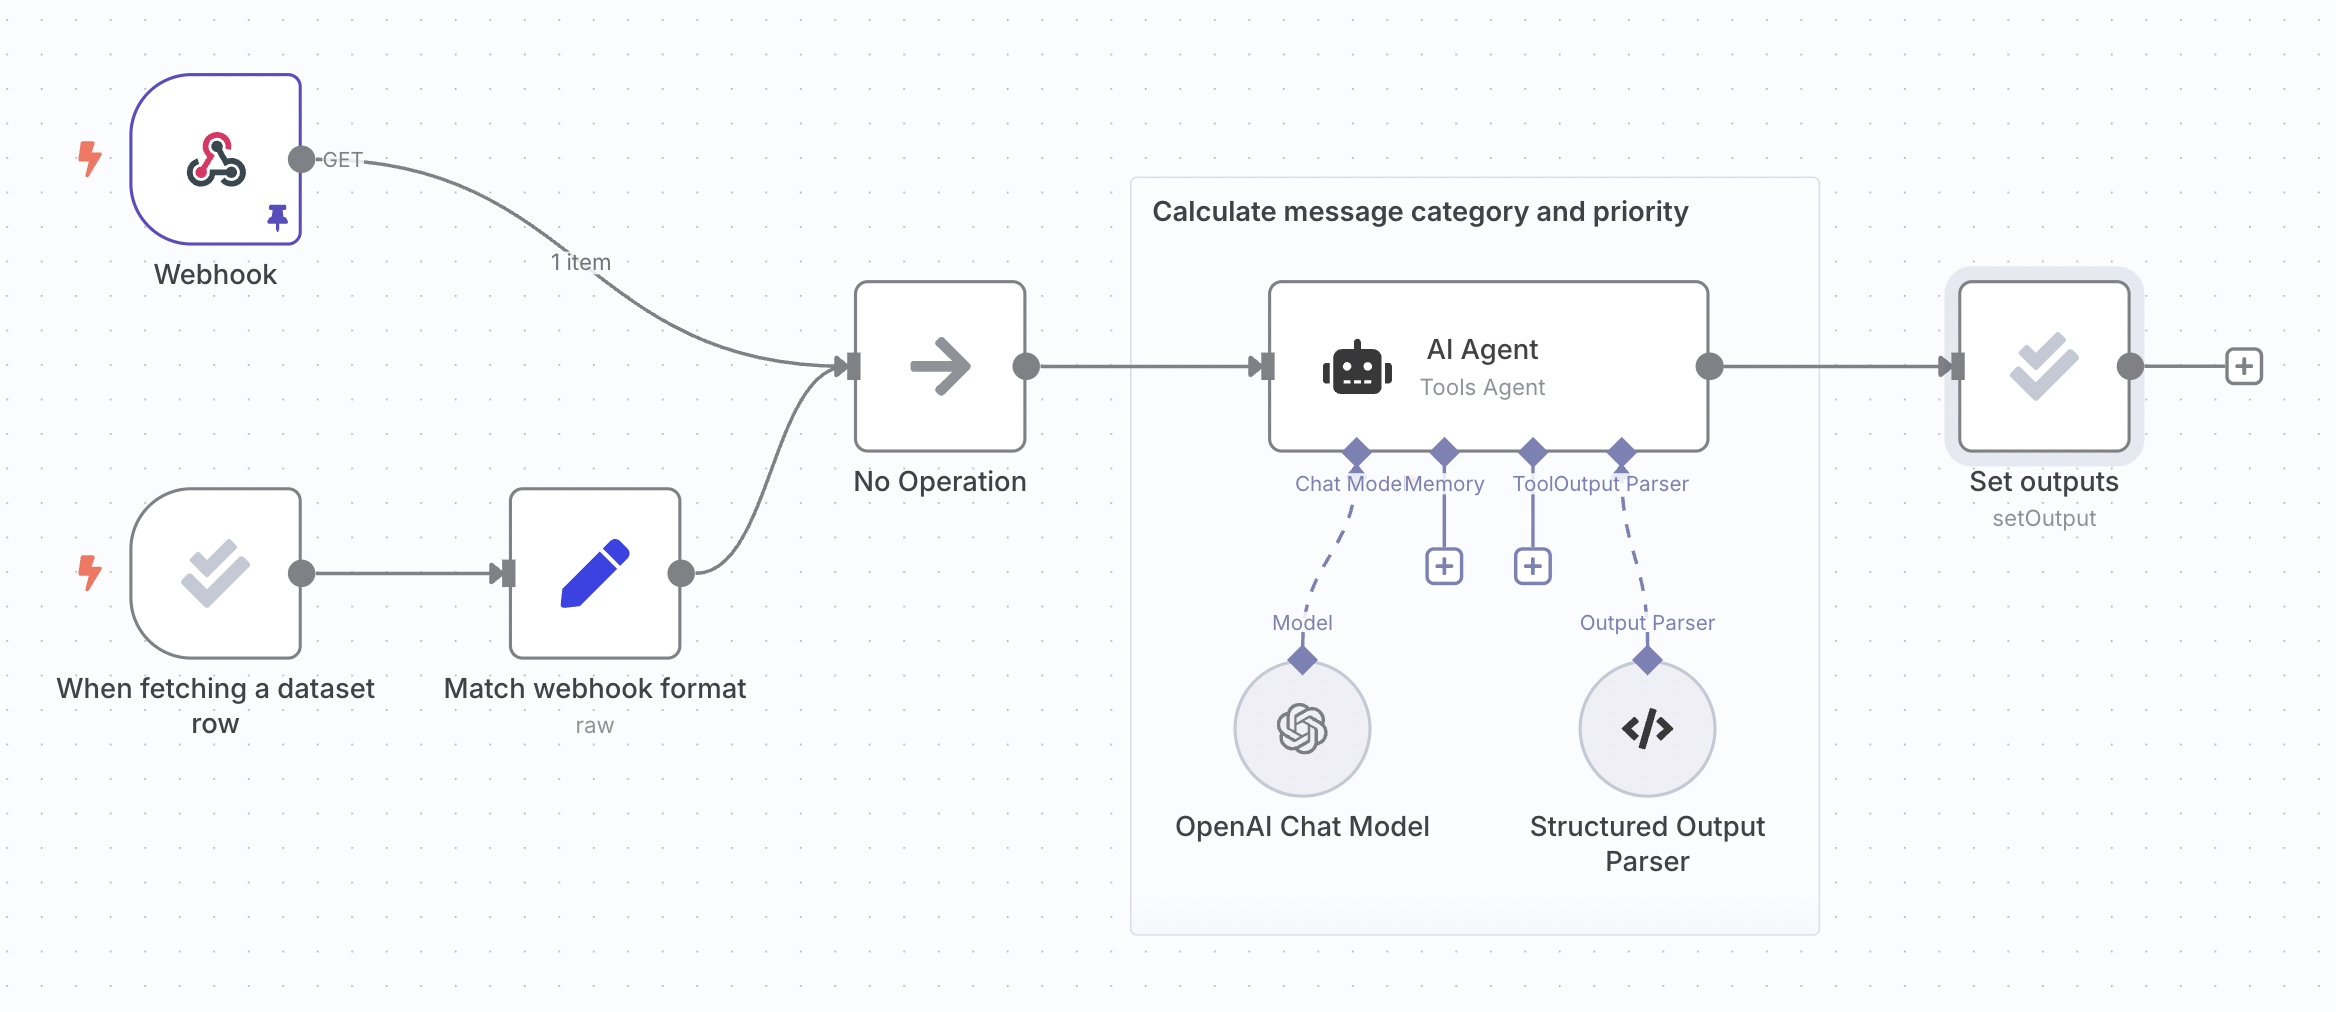
以下步骤使用来自轻量级评估文档的相同支持工单分类工作流:
2. 将指标添加到工作流程
指标是用于对工作流输出进行评分的维度。它们通常将实际工作流输出与参考输出进行比较。通常使用 AI 来计算指标,尽管有时也可以只使用代码。在 n8n 中,指标始终是数字。
您需要添加逻辑来计算工作流的指标,在工作流产生输出之后的某个点。您可以将指标使用的任何参考输出作为数据集中的列添加。这确保它们在工作流中可用,因为它们将由评估触发器输出。
使用 设置指标 操作来计算:
- 正确性(基于 AI):答案的含义是否与提供的参考答案一致。使用 1 到 5 的评分,5 为最佳。
- 有用性(基于 AI):响应是否回答了给定的查询。使用 1 到 5 的评分,5 为最佳。
- 字符串相似性:答案与参考答案的接近程度,按字符逐个测量(编辑距离)。返回 0 到 1 之间的分数。
- 分类:答案是否与参考答案完全匹配。匹配时返回 1,否则返回 0。
- 使用的工具:执行是否使用了工具。返回 0 到 1 之间的分数。
您还可以添加自定义指标。只需在工作流内计算指标,然后将它们映射到评估节点。使用 设置指标 操作并选择 自定义指标 作为指标。然后您可以设置要返回的指标的名称和值。
例如:
- RAG 文档相关性:在使用向量数据库时,检索的文档是否与问题相关。
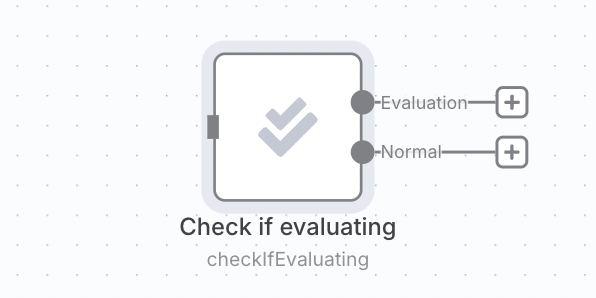
计算指标会增加延迟和成本,因此您可能只想在运行评估时执行此操作,并在生产执行时避免执行。您可以通过将度量逻辑放在“检查是否评估”操作 之后来完成此操作。
3. 运行评估并查看结果
切换到工作流的 Evaluations 评估 标签页,然后点击 Run Test 运行测试 按钮。评估会开始运行。评估完成后,它会显示每个指标的汇总分数。
你可以点击测试运行行,查看每个测试用例的结果。点击单个测试用例会在新标签页中打开生成该结果的执行。
并行运行测试用例
在支持并发的套餐中,Run Test 运行测试 是一个拆分按钮。右侧的插入符号会打开一个弹出层,其中的滑块可控制同时运行多少个测试用例。
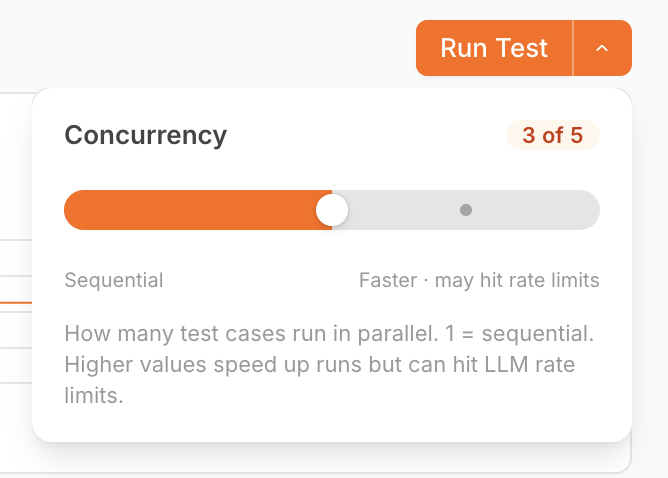
默认最大值取决于你的套餐:
| 套餐 | 最大并行测试用例数 |
|---|---|
| Self-hosted Community、n8n Cloud Pro | 1(顺序运行) |
| Self-hosted Business | 3 |
| n8n Cloud Enterprise、自托管 Enterprise | 5 |
当最大值为 1 时,插入符号和弹出层会被隐藏,Run Test 运行测试 会显示为普通按钮,运行方式为顺序执行,与早期版本相同。
无论计划层如何,自托管实例都可以使用 N8N_CONCURRENCY_EVALUATION_LIMIT 环境变量覆盖最大值。
提示
LLM rate limits LLM 速率限制
更高的并发性可以加快评估运行速度,但会增加达到上游 LLM 速率限制的机会。如果您看到速率限制错误,请降低滑块。